图没有固定的“第一个元素”或“下一个元素”。要系统地访问顶点,必须规定选择起点、邻居顺序以及待访问顶点的调度方式,这就是图遍历(graph traversal)。本节介绍深度优先搜索(DFS)和广度优先搜索(BFS):DFS 沿当前分支深入,无法继续时回退;BFS 从起点按距离层次向外扩展。二者都能覆盖起点可达的顶点,但访问顺序与适用任务不同。
第 6.3 节已经用遍历计算可达集合、无向连通分量、弱连通分量和强连通分量。本节保留一份简洁的 DFS/BFS 骨架以便独立阅读,但不再展开连通分量算法;重点转向访问顺序为什么不同,以及这些顺序能证明和解决什么。四个问题贯穿全节:
- 为什么必须标记"已访问"?什么时候标记?
- DFS 怎么走?递归和显式栈有什么不同?
- BFS 怎么走?为什么它能求无权图最短距离?
- 两种遍历的代价各是多少?什么时候该选哪一个?
学习目标
完成本节后,你应该能够:
- 说出图遍历要解决什么问题,以及
visited标记的作用; - 手推 DFS 与 BFS 在给定邻接表上的访问顺序;
- 用递归与显式栈实现 DFS,用队列实现 BFS;
- 解释"入队/入栈时标记"为什么优于"出队/出栈时标记";
- 说明 BFS 为什么能得到无权最短距离,DFS 为什么不能;
- 比较两种遍历在邻接表与邻接矩阵下的时间、空间复杂度;
- 用发现时间与完成时间描述 DFS 树中的祖先关系(括号化定理);
- 对 DFS 产生的边进行分类,并用后向边判断有向图是否存在环。
一张小图,两条路线
下面这张图有 5 个顶点、4 条边。本节所有示例都用它,方便对比两种走法:
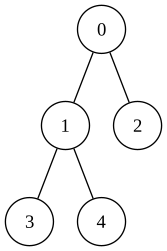
从顶点 0 出发:
DFS:认准一条路走到底,走不通就回头换一条。
text第 1 条路:0 → 1 → 3 3 走不通,退回 1 第 2 条路:1 → 4 4 走不通,退回 0 第 3 条路:0 → 2 2 走不通,结束 访问顺序:0, 1, 3, 4, 2BFS:先访问近的,再一层一层往外扩。
text第 0 层:{0} 第 1 层:{1, 2} 第 2 层:{3, 4} 访问顺序:0, 1, 2, 3, 4
两种走法访问的顶点完全相同,顺序不同。后面所有概念——标记、栈、队列、复杂度、最短距离——都围绕这两张路线图展开:先记住"怎么走",再研究"为什么"。
示例图为什么没有环
这张示例图故意不设环,先把"怎么走"看清。环会在后面的标记部分专门处理——正是它逼出了 visited 数组。
遍历问题与前置约定
什么是图遍历
定义 · 图遍历
设
有向图怎么办
有向图的情形类似,但沿边移动必须遵守方向:邻居列表改为出边列表,单次遍历覆盖的是从起点可达的顶点集合,不要把它误称为强连通分量。本节示例与复杂度分析主要使用无向图;后文讨论 DFS 边分类和有向环检测时会明确加入方向条件。
为什么"至多一次"要专门写出来?因为图里可能有环:A → B → C → A 这样的环会让"沿边一直走"永远停不下来。无向图的边也会带来同样的麻烦——0 和 1 相邻,从 1 回头就能走回 0。标记数组 visited 记录哪些顶点已经访问过,是遍历正确性的前提,不是可选项。
性质 · 两种标记时机
- 第一时间标记:进入递归函数时、入队时或入栈时立刻标记,顶点在等待期间不会被重复加入;
- 延迟标记:等到取出顶点时才标记(出队时、出栈时),同一顶点可能在等待期间被多次加入,队列或栈会膨胀,还得额外去重。
本节所有实现都采用第一种:第一时间标记。注意,递归 DFS 没有显式的"出栈"动作,重复入栈问题只出现在显式栈版本里。
用什么存图:邻接表
遍历的代价取决于“找邻居”的成本。6.2 图的存储结构介绍了两种主要表示:邻接矩阵能以
#include <algorithm>
#include <iostream>
#include <vector>

int n = 0, m = 0;
std::cin >> n >> m;
std::vector<std::vector<int>> graph(n);   // graph[u] 是顶点 u 的邻居列表
for (int i = 0; i < m; ++i) {
    int u = 0, v = 0;
    std::cin >> u >> v;
    graph[u].push_back(v);
    graph[v].push_back(u);   // 无向边记录两个方向
}
// 升序排列邻居,让遍历结果唯一可复现
for (auto& neighbors : graph) std::sort(neighbors.begin(), neighbors.end());这段代码做四件事:读入顶点数 graph[u] 里放 v,graph[v] 里放 u);最后把每个顶点的邻居按编号升序排好。之后遍历时,只需要不断问"当前顶点的邻居是谁"。
为什么排序邻居
遍历结果取决于"先访问哪个邻居"。题目要求结果唯一时,通常规定邻居按编号升序访问,本文示例也是如此。代码里最后一行 sort 就是为这个约定服务的。
DFS:深度优先搜索
直觉:走到底,再回头
DFS 的规则一句话:能深入就深入,深入不了就退回一步,换下一个没走过的邻居。前面小图里,0 → 1 → 3 走到死路后退回 1 换走 4;4 也走不通,再一路退回 0 走 2——这个过程就是回溯(backtracking)。
直觉 · 与树的先序遍历同构
一棵树的 DFS 就是第 4 章二叉树的先序遍历:访问根,再依次先序遍历每个子树。图的 DFS 只是多了一道约束——图里有环,要用 visited 挡住"走回祖先"的回头路。图的递归代码和树的递归代码几乎一样,只是把 left/right 换成了"邻居列表"。
递归实现
递归代码直接对应规则:访问当前顶点,再对每个未访问的邻居递归进入。
#include <vector>

std::vector<std::vector<int>> graph;
std::vector<bool> visited;
std::vector<int> order;

void dfs(int u) {
    visited[u] = true;
    order.push_back(u);
    for (int v : graph[u]) {
        if (!visited[v]) dfs(v);
    }
}函数体只有三件事:visited[u] = true 标记当前顶点;order.push_back(u) 记录访问顺序;for 循环逐个处理未访问的邻居,对每个邻居递归调用自身。这里把图、访问标记和输出序列统一作为程序状态,dfs(u) 只保留“从 u 继续搜索”这一件事。某个邻居的整棵子树走完后,函数返回,循环继续检查下一个邻居——代码里的"返回"就是直觉里的"回头"。
示例 · 递归 DFS 怎么走
对照路线图,从 0 出发,邻居升序:
| 步骤 | 动作 | 调用栈(自底向上) | 访问顺序 |
|---|---|---|---|
| 1 | 进入 0 | 0 | 0 |
| 2 | 进入 1 | 0, 1 | 0, 1 |
| 3 | 进入 3 | 0, 1, 3 | 0, 1, 3 |
| 4 | 3 无路可走,返回 1 后进入 4 | 0, 1, 4 | 0, 1, 3, 4 |
| 5 | 4 无路可走,一路返回 0 后进入 2 | 0, 2 | 0, 1, 3, 4, 2 |
| 6 | 2 无路可走,依次返回 | 空 | 完成 |
第 4、5 步是关键:3 只有邻居 1 且已访问,函数就一层层返回;回到 1 发现还有没走过的 4,于是进入第二条路。这就是"走不通就回头换一条"。
上面的 order 记录的是发现顺序:顶点第一次被访问的顺序。如果把 order.push_back(u) 移到递归调用全部返回之后,记录的就是完成顺序——它对应树的"后序遍历",在拓扑排序(给有向图的顶点排一个"依赖在前"的线性顺序)等场景中更有用。两种顺序都是 DFS 的合法输出,题目问哪一种,要看它要求输出什么。
显式栈实现
递归的调用栈由系统保存“返回后从哪里继续”等信息。如果图是一条很长的链,递归深度会达到顶点数
若要求与递归版严格一致,显式栈必须保存“顶点 + 下一个邻居下标”的递归帧,逐个处理升序邻居;简单地把所有邻居逆序压栈并在入栈时标记,只能保证可达集合相同,遇到交叉边时访问顺序可能不同。
#include <stack>
#include <vector>

std::vector<std::vector<int>> graph;
std::vector<bool> visited;
std::vector<int> order;

void dfs_iterative(int start) {
    std::stack<int> pending;
    pending.push(start);
    // 入栈时标记,避免同一顶点重复入栈
    visited[start] = true;
    while (!pending.empty()) {
        int u = pending.top();
        pending.pop();
        order.push_back(u);
        // 逆序入栈,弹出时即按升序访问
        for (int i = static_cast<int>(graph[u].size()) - 1; i >= 0; --i) {
            int v = graph[u][i];
            if (!visited[v]) {
                visited[v] = true;
                pending.push(v);
            }
        }
    }
}上面的简化代码只用于说明“待访问顶点”栈;严格模拟递归时,应将待处理邻居下标一并保存于栈帧中。这样每次只深入一个邻居,返回后再继续当前顶点的下一个邻居,才能在交叉边场景保持完全相同的发现顺序。
易错点 · 两种 DFS 的访问顺序不必相同
- 区别:递归版在进入时标记、立即深入;显式栈版在入栈时标记、出栈后才访问。
- 后果:入栈顺序、标记时机不同,访问顺序可能不同;始终一致的是"访问过的顶点集合"。
- 约定:想和递归版顺序一致,应使用“递归帧 + 逐邻居推进”;逆序批量压栈不提供严格顺序保证。
复杂度
复杂度 · DFS
令 visited 与栈各占
DFS 能做什么
"深入 + 回溯"适合需要探索完整路径的问题:
- 连通分量:一次 DFS 覆盖起点所在分量;对所有未访问顶点各启动一次,就能数出全图有几个分量;
- 环检测:无向图中,DFS 遇到"已访问但不是父顶点"的邻居,说明存在环。这里"父顶点"指从它一步走到当前顶点的那个顶点;
- 回溯枚举:八皇后、排列组合、迷宫路径这类"试一条路、不行就退"的问题,本质都是 DFS。
DFS 不保证最短
DFS 优先深入,第一次到达某顶点时走过的边数未必最少。无权图的最短距离要交给 BFS。
DFS 时间戳与括号化定理
DFS 除了输出"访问顺序",还可以给每个顶点记下两个时间戳,从而精确刻画顶点在 DFS 树中的祖先关系。递归版 DFS 在进入顶点时记录发现时间,在所有邻居处理完毕、返回之前记录完成时间:
#include <iostream>
#include <vector>

using namespace std;

vector<vector<int>> graph;
vector<bool> visited;
vector<int> discover, finish;
int timer = 0;   // 全局时钟

void dfs(int u) {
    visited[u] = true;
    discover[u] = ++timer;     // 发现时间:进入顶点时
    for (int v : graph[u]) {
        if (!visited[v]) dfs(v);
    }
    finish[u] = ++timer;       // 完成时间:全部邻居处理完后
}这里把同一次 DFS 需要的状态统一放在程序级变量中:dfs 只接受当前顶点 u,读写 visited、discover、finish 和 timer。这正是许多数据结构教材中最常见的写法:递归函数只表达“从当前顶点继续搜索”,不把一长串容器参数夹在算法主线中。若要封装成库函数,再把这些状态放入一个对象或上下文结构即可。
上面的 dfs 只从 u 出发,覆盖 u 所在的可达分量。若想让全图每个顶点都有时间戳(构造完整 DFS 森林),需要在外层对所有未访问顶点各启动一次:
for (int v = 0; v < n; ++v) {
    if (!visited[v]) dfs(v);
}定义 · 发现时间与完成时间
顶点 dfs(u) 只覆盖
定理 · 括号化定理
对同一棵 DFS 树中的任意两个顶点
是 的祖先,且 ,即 的区间完整包含 的区间; 是 的祖先,且 ; 、 互不为祖先,两个区间互不相交。
易错点 · 只看完成时间不够
仅由
DFS 边分类
DFS 过程中顶点的状态可以看作三种"颜色":白色(尚未发现)、灰色(已发现、尚未完成,仍在递归栈中)、黑色(已完成)。当 DFS 检查一条边
定义 · DFS 边的四种类型
- 树边:
为白色, 成为 DFS 树中的一条边; - 后向边:
为灰色,即 是 的祖先; - 前向边:
为黑色且是 的后代; - 交叉边:
为黑色但不是 的后代。
示例 · 后向边与交叉边
有向图边集
性质 · 无后向边与无环
有向图存在环,当且仅当其 DFS 森林中存在后向边。因此 DFS 森林中无后向边等价于该图是无环有向图(DAG),而 DAG 一定存在拓扑排序。
DFS 拓展:从七桥问题到欧拉路径
先看一个现实问题:哥尼斯堡七桥
18 世纪的哥尼斯堡城被普雷格尔河分成四块陆地,七座桥把这些陆地连接起来。人们提出了一个问题:
能不能从某块陆地出发,恰好经过每座桥一次,最后回到原来的位置?
把每块陆地看成顶点,把桥看成边,问题就变成“是否存在一条经过每条边恰好一次的回路”。欧拉把这件事抽象成图论问题,并发现不需要尝试所有走法,只要观察每个顶点连接了多少条边即可。
定义 · 欧拉路径与欧拉回路
在无向图中,经过每条边恰好一次的路线叫欧拉路径;如果路线的起点和终点相同,叫欧拉回路。顶点可以重复经过,但边不能重复使用。
度数为什么决定答案
每次进入一个中间顶点,都必须再从另一条边离开,所以中间顶点的边必须两两配对,度数只能是偶数。若路线从顶点出发但不回到它,起点会多“离开”一次,终点会多“进入”一次,因此恰好允许两个奇度顶点。
定理 · 无向图欧拉路线判定
忽略孤立顶点后,图连通时:
- 所有顶点度数为偶数,当且仅当存在欧拉回路;
- 恰好两个顶点度数为奇数,当且仅当存在欧拉路径但不存在欧拉回路;
- 奇度顶点不是
0或2时,不存在欧拉路径。
证明
必要性来自“进入和离开配对”:回路中每个顶点每进入一次就必须离开一次,所以每个顶点度数为偶数;非闭合路径只有起点和终点各少配对一次,所以它们为奇数,其余顶点为偶数。
充分性可以用构造法证明。若所有度数为偶数,从任意非孤立顶点出发不断选择尚未使用的边,不能在中途停下:每次到达一个非起点顶点时,已用边数与未用边数保持配对,最终只能回到起点,得到一个闭合回路。若还有未使用的边,连通性保证它与已有回路相交;从交点再走出一个回路并拼接,反复进行即可覆盖所有边。恰有两个奇度顶点时,从其中一个出发,除起点和终点外仍然可以成对进出,最终在另一个奇度顶点结束;同样拼接剩余回路即可。
七桥图的四块陆地中,每个顶点的度数都是奇数,共有四个奇度顶点,不满足 0 或 2 的条件,因此不存在这样的路线。这就是七桥问题的结论。
Hierholzer 算法:把证明变成程序
上面的充分性证明本身就是算法。沿未使用的边前进;走到当前顶点没有未用边时,把它放入答案并回退。因为答案是从“走不动”的末端逆向记录的,最后需要反转。这里直接用递归 DFS 表达这个回溯过程:递归调用负责沿边深入,函数返回前把当前顶点加入路径。
vector<vector<pair<int, int>>> graph;
vector<bool> used;
vector<int> path, next_edge;

void euler_dfs(int u) {
    while (next_edge[u] < static_cast<int>(graph[u].size())) {
        auto [v, id] = graph[u][next_edge[u]++];
        if (used[id]) continue;
        used[id] = true;
        euler_dfs(v);
    }
    path.push_back(u);
}这段功能代码只展示 Hierholzer 的 DFS 核心。与普通 DFS 的关键区别是:普通 DFS 标记“顶点是否访问过”,Hierholzer 标记“边是否使用过”;同一顶点可以多次进入。若图有重边,必须给每条边独立编号,不能只用 visited[v]。
可编译 C++17 完整实现 · 判定并输出欧拉路线
#include <algorithm>
#include <iostream>
#include <utility>
#include <vector>

using namespace std;

vector<vector<pair<int, int>>> graph;
vector<bool> used;
vector<int> path, next_edge;

void euler_dfs(int u) {
    while (next_edge[u] < static_cast<int>(graph[u].size())) {
        auto [v, id] = graph[u][next_edge[u]++];
        if (used[id]) continue;
        used[id] = true;
        euler_dfs(v);
    }
    path.push_back(u);
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m;
    cin >> n >> m;
    vector<int> degree(n, 0);
    graph.assign(n, {});

    for (int i = 0; i < m; ++i) {
        int u, v;
        cin >> u >> v;
        graph[u].push_back({v, i});
        graph[v].push_back({u, i});
        ++degree[u];
        ++degree[v];
    }

    int odd = 0;
    int start = -1;
    for (int u = 0; u < n; ++u) {
        if (degree[u] % 2 == 1) {
            ++odd;
            if (start == -1) start = u;
        }
        if (start == -1 && degree[u] > 0) start = u;
    }

    if (odd != 0 && odd != 2) {
        cout << "NO\n";
        return 0;
    }
    if (m == 0) {
        cout << "YES\n0\n";
        return 0;
    }

    used.assign(m, false);
    next_edge.assign(n, 0);
    euler_dfs(start);

    if (static_cast<int>(path.size()) != m + 1) {
        cout << "NO\n";
        return 0;
    }
    reverse(path.begin(), path.end());
    cout << "YES\n";
    for (int i = 0; i < static_cast<int>(path.size()); ++i) {
        if (i) cout << ' ';
        cout << path[i];
    }
    cout << '\n';
}BFS:广度优先搜索
直觉:一圈一圈往外扩
本节讨论的是无权图,即每条边的代价都视为 1;BFS 的“按层”只在这一前提下直接给出最短距离。边权非负时可使用7.4 节的 Dijkstra;允许负权边时还需根据是否存在负环等条件选择 Bellman-Ford 等算法。BFS 的规则一句话:先访问起点,再访问起点的全部邻居,再访问邻居的邻居。前面小图里,{1, 2} 是第 1 层,{3, 4} 是第 2 层,BFS 严格按层访问。队列的"先进先出(FIFO)"恰好保证这一点:先入队的(更近的)一定先出队。第 2 章的队列应用已预告过这种"按层扩散",这里正式用在图上。
定义 · 按层访问
把到起点
队列实现
DFS 用栈式调度(后进先出,先深入),BFS 用队列调度(先进先出,先扩散),这是两者访问次序的核心区别。下面代码同时维护访问顺序 order 和距离 dist:dist[v] 表示 -1 兼作"未访问"标记。
#include <queue>
#include <vector>

std::vector<std::vector<int>> graph;
std::vector<int> order, dist;

void bfs(int start) {
    int n = static_cast<int>(graph.size());
    dist.assign(n, -1);         // -1 表示未访问
    std::queue<int> pending;
    pending.push(start);
    // 入队时标记:起点距离为 0
    dist[start] = 0;
    while (!pending.empty()) {
        int u = pending.front();
        pending.pop();
        order.push_back(u);
        for (int v : graph[u]) {
            if (dist[v] != -1) continue;   // 已入过队的顶点跳过
            // 邻居比当前顶点远一层
            dist[v] = dist[u] + 1;
            pending.push(v);
        }
    }
}这份代码里,pending 是"等待访问"的队列:每轮取出队首顶点 u 访问,再把它尚未访问的邻居 v 加入队尾,同时用 dist[v] = dist[u] + 1 记下"v 比 u 远一层"。因为队列先进先出,先入队的顶点一定先被处理,这正是按层扩散。dist 第一次被赋值时就是最短距离,下一小节会给出证明。
注意 -1 的双重语义:遍历过程中 dist[v] == -1 表示"尚未发现";遍历结束后仍为 -1 的顶点才是真正不可达。用同一个值兼任标记与最终结果,是常见的省空间写法,区分靠的是"遍历是否结束"。
示例 · BFS 队列变化
对照路线图,从 0 出发:
| 步骤 | 出队 | 新入队 | 队列(队首 → 队尾) | 距离 |
|---|---|---|---|---|
| 初始 | — | 0 | 0 | dist[0] = 0 |
| 1 | 0 | 1, 2 | 1, 2 | dist[1] = dist[2] = 1 |
| 2 | 1 | 3, 4 | 2, 3, 4 | dist[3] = dist[4] = 2 |
| 3 | 2 | — | 3, 4 | — |
| 4 | 3 | — | 4 | — |
| 5 | 4 | — | 空 | — |
访问顺序 0, 1, 2, 3, 4,距离 dist = [0, 1, 1, 2, 2]。注意第 1 层 {1, 2} 全部先于第 2 层 {3, 4} 出队——这正是"先进先出"的效果。
为什么 BFS 第一次到达就是最短距离
这是 BFS 最重要的一条性质,也是它和 DFS 的根本区别。先约定记号:
定理 · BFS 的无权最短距离
无权图 dist[v] 就等于
证明
先用队列的性质:FIFO 保证第
对层数 dist 都等于 dist[s]=0,成立。假设第 dist[v] = dist[u] + 1 = k + 1。若
推论 · 无权图最短路径
边权相同(无权)的图中,从 -1。
复杂度
复杂度 · BFS
邻接表上每个顶点入队一次、每条边扫描一次,时间为 dist 与队列各占
BFS 能做什么
- 无权最短路径:
dist数组就是答案; - 按层处理:需要"先处理近的,再处理远的"的问题,如状态空间(把每种局面抽象成一个顶点的图)最少步数、迷宫最短路;
- 二分图判定:给顶点交替染色,BFS 逐层扩散时若发现相邻同色,就不是二分图。
完整解题范例
下面用两道可以直接提交和运行的题,把 DFS 与 BFS 从“遍历骨架”落实为完整解题流程。第一题强调 DFS 的进入/退出事件,第二题强调 BFS 的分层与入队标记。
范例一:完整 DFS 森林的时间戳
题目解读
给定一个可能不连通的无向图,顶点编号为 0..n-1。外层按编号升序寻找尚未访问的顶点,每个顶点的邻居也按升序访问。第一次进入顶点 u 时记录发现时间 d[u],处理完全部邻居、退出 u 时记录完成时间 f[u],最后输出两个数组。
题目中的“可能不连通”决定了不能只调用一次 DFS;“退出时记录”决定了显式栈不能只保存顶点,还要保存下一个待检查的邻居下标。
算法分析
使用栈帧 (u, next) 模拟递归调用:
- 顶点第一次压栈时记录
d[u]; next指向graph[u]中下一条尚未检查的邻接记录;- 若还有未访问邻居,就先推进
next,再把邻居作为新栈帧压入; - 若邻居全部处理完,记录
f[u]并弹出当前帧; - 外层扫描所有顶点,得到完整 DFS 森林。
排序邻接表需要
伪代码
timer = 0
visited = 全 false
for root = 0 .. n-1:
    if visited[root]: continue
    标记 root,d[root] = ++timer
    stack.push((root, 0))
    while stack 非空:
        (u, next) = stack.top
        if next == graph[u].size:
            f[u] = ++timer
            stack.pop
        else:
            v = graph[u][next]
            stack.top.next++
            if not visited[v]:
                标记 v,d[v] = ++timer
stack.push((v, 0))最终代码
可编译 C++17 实现
#include <algorithm>
#include <cstddef>
#include <iostream>
#include <utility>
#include <vector>

int main() {
    std::ios::sync_with_stdio(false);
    std::cin.tie(nullptr);

    int n = 0, m = 0;
    if (!(std::cin >> n >> m)) return 0;

    std::vector<std::vector<int>> graph(n);
    for (int i = 0; i < m; ++i) {
        int u = 0, v = 0;
        std::cin >> u >> v;
        graph[u].push_back(v);
        graph[v].push_back(u);
    }
    for (auto& neighbors : graph) {
        std::sort(neighbors.begin(), neighbors.end());
    }

    std::vector<bool> visited(n, false);
    std::vector<int> discovered(n), finished(n);
    int timer = 0;

    for (int root = 0; root < n; ++root) {
        if (visited[root]) continue;
        visited[root] = true;
        discovered[root] = ++timer;
        std::vector<std::pair<int, std::size_t>> stack{{root, 0}};

        while (!stack.empty()) {
            int u = stack.back().first;
            std::size_t& next = stack.back().second;
            if (next == graph[u].size()) {
                finished[u] = ++timer;
                stack.pop_back();
                continue;
            }

            int v = graph[u][next++];
            if (visited[v]) continue;
            visited[v] = true;
            discovered[v] = ++timer;
            stack.push_back({v, 0});
        }
    }

    for (int u = 0; u < n; ++u) {
        if (u) std::cout << ' ';
        std::cout << discovered[u];
    }
    std::cout << '\n';
    for (int u = 0; u < n; ++u) {
        if (u) std::cout << ' ';
        std::cout << finished[u];
    }
    std::cout << '\n';
}拓展、思考与变式
- 若只保存“待访问顶点”而不保存
next,就无法准确产生递归版的完成时间; - 把无向图改成有向图后,同一套时间戳可继续用于祖先判断和边分类;
- 若题目只要求发现顺序,可以简化为普通顶点栈,不再记录退出事件;
- 对应练习:T01 · 07E01 · DFS 遍历与时间戳;完成后可继续做 T03 · 07E03 · DFS 边分类统计。
范例二:BFS 判定二分图
题目解读
给定一个可能不连通的无向图,尝试把每个顶点染成 0/1 两色,使每条边的两个端点颜色不同。若成功,输出 YES 和颜色数组;若遇到同色相邻顶点,输出 NO 和第一条冲突边。
一条边会把“端点异色”变成约束 color[v] = 1 - color[u]。非连通图的每个分量都要单独选择起点;为了让“第一条冲突边”可复现,根和邻居都按编号升序处理。
算法分析
对每个未染色根执行 BFS:根染 0 并入队;扫描边 u-v 时,若 v 未染色,就给它染相反颜色并立即入队;若 v 已染色且与 u 同色,则图不是二分图。
染色同时充当访问标记,所以每个顶点最多入队一次。排序后 BFS 为
伪代码
color = 全 -1
for root = 0 .. n-1:
    if color[root] != -1: continue
    color[root] = 0
    root 入队
    while 队列非空:
        u = 出队
        for v in graph[u]:
            if color[v] == -1:
                color[v] = 1 - color[u]
                v 入队
            else if color[v] == color[u]:
                输出 NO 与冲突边并结束
输出 YES 与 color最终代码
可编译 C++17 实现
#include <algorithm>
#include <iostream>
#include <queue>
#include <vector>

int main() {
    std::ios::sync_with_stdio(false);
    std::cin.tie(nullptr);

    int n = 0, m = 0;
    if (!(std::cin >> n >> m)) return 0;

    std::vector<std::vector<int>> graph(n);
    for (int i = 0; i < m; ++i) {
        int u = 0, v = 0;
        std::cin >> u >> v;
        graph[u].push_back(v);
        graph[v].push_back(u);
    }
    for (auto& neighbors : graph) {
        std::sort(neighbors.begin(), neighbors.end());
    }

    std::vector<int> color(n, -1);
    std::queue<int> pending;
    for (int root = 0; root < n; ++root) {
        if (color[root] != -1) continue;
        color[root] = 0;
        pending.push(root);

        while (!pending.empty()) {
            int u = pending.front();
            pending.pop();
            for (int v : graph[u]) {
                if (color[v] == -1) {
                    color[v] = 1 - color[u];
                    pending.push(v);
                } else if (color[v] == color[u]) {
                    std::cout << "NO\n";
                    std::cout << std::min(u, v) << ' '
                              << std::max(u, v) << '\n';
                    return 0;
                }
            }
        }
    }

    std::cout << "YES\n";
    for (int u = 0; u < n; ++u) {
        if (u) std::cout << ' ';
        std::cout << color[u];
    }
    std::cout << '\n';
}拓展、思考与变式
- 将 BFS 换成 DFS 不会改变是否为二分图,但可能改变颜色方案和首先发现的冲突边;
- 保存父节点后,可以从同色冲突边的两个端点回溯并还原一个奇环;
- 动态加边场景可使用带奇偶关系的并查集,但它不直接提供 BFS 层次;
一张表对比
| 维度 | DFS | BFS |
|---|---|---|
| 辅助结构 | 栈(递归或显式栈) | 队列 |
| 访问顺序 | 沿一条链深入,回头换链 | 按层逐圈扩散 |
| 无权最短距离 | 不保证 | 首次入队即最短 |
| 空间 | ||
| 实现形态 | 递归直观;显式栈防爆栈 | 迭代 + 队列 |
| 典型场景 | 连通分量、环检测、回溯 | 无权最短路、按层处理 |
邻接表下两者都是
渐近空间都是
易错点
易错点 · 标记时机
- 错误做法:等到出队/出栈时才标记。
- 后果:同一顶点被多个邻居反复加入,队列或栈膨胀到
量级。 - 正确做法:入队/入栈/进入时立刻标记。
易错点 · 非连通图只访问一个分量
- 错误做法:只从起点跑一次遍历,就以为访问了全图。
- 后果:其余分量的顶点完全没被访问。
- 正确做法:对每个尚未访问的顶点依次启动遍历;只问"从
可达"时,不可达顶点保留 -1。
易错点 · 递归深度爆栈
- 错误做法:深图(如
的链)上直接递归 DFS。 - 后果:递归深度等于路径长度,系统栈溢出。
- 正确做法:改用显式栈 DFS,或换 BFS。
易错点 · 邻居顺序影响结果
- 错误做法:不排序,直接按输入顺序访问邻居。
- 后果:同一张图可能输出不同的遍历序列。
- 正确做法:题目要求结果唯一时,先看邻居顺序规定(通常升序),再写代码。
易错点 · 栈与队列混用
- 错误做法:把 BFS 的
queue换成stack,或把 DFS 的栈换成队列。 - 后果:程序不会崩溃,但访问顺序变成另一种风格——BFS 用栈会"沿一条链深入",
dist也不再是最短距离。 - 正确做法:写完先在小图上手推一遍(比如本文示例图),确认顺序符合直觉再提交。
练习
复述
- 为什么 BFS 必须入队时标记?改成出队时标记,时间和空间分别会怎样?
推演
- 用本节示例图,手推从顶点
3出发的 DFS 与 BFS 访问顺序,比较差异。 - 若图改用邻接矩阵存储,BFS 的复杂度变成多少?在顶点数很大的稀疏图上,为什么通常应优先考虑邻接表?
- 图不连通时,从固定源点
运行一次 BFS 后,不可达顶点的距离应如何表示?如果目标改为遍历全图并为每个连通分量建立一棵 BFS 树,又该怎么做?
迁移
- 画一个从
到 的图,使 DFS 从 出发优先访问的路径不是最短路径,并标注 DFS 的访问顺序,说明为什么 DFS 第一次到达 的边数可能不是最少的。 - 显式栈 DFS 的"逆序入栈"和"入栈时标记"各自解决什么问题?去掉其中一个,示例顺序会怎么变?
- 递归 DFS 在
的链状图上可能发生什么?换成显式栈后,时间复杂度和渐近空间复杂度是否改变?为什么显式栈通常能容纳更深的遍历,但仍可能因内存不足而失败?
代码题练习
按本节下方的 Lab 入口练习。下列入口使用稳定 Lab 编号。